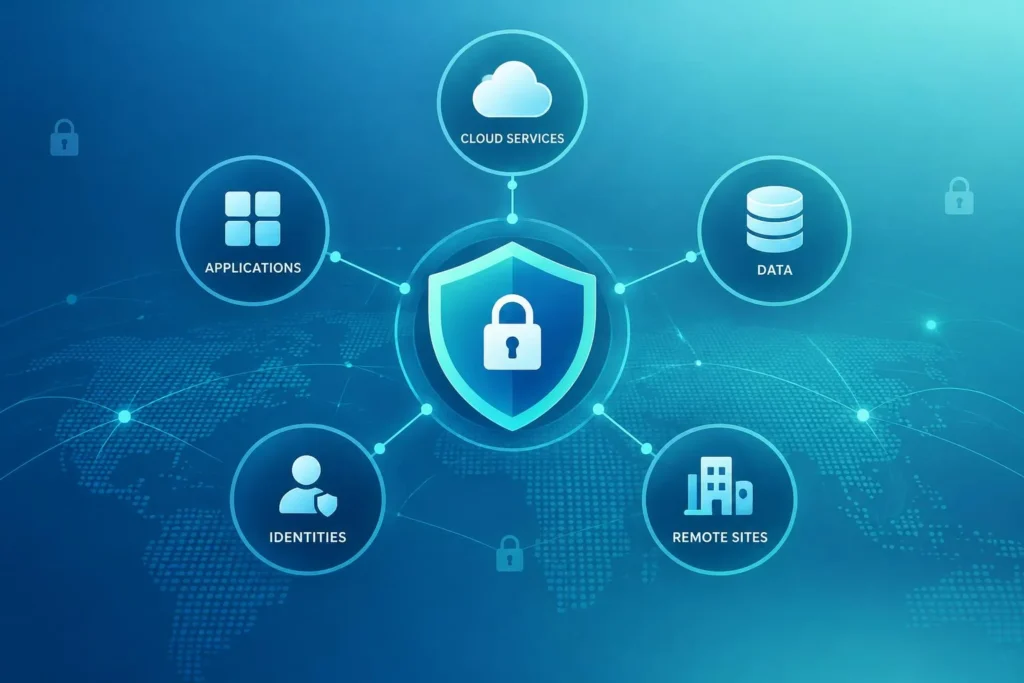
Une infrastructure IT B2B relie les applications métier, les données, les identités, les sites distants et les services cloud. La sécuriser revient à préserver la confidentialité, l’intégrité et la disponibilité des ressources sans ralentir l’exploitation. Pour avancer efficacement, l’entreprise doit d’abord traiter les risques capables d’interrompre son activité ou d’exposer ses données sensibles.
1. Cartographier ce qui compte vraiment pour l’activité
Avant d’ajouter des outils de sécurité, l’entreprise doit savoir précisément ce qu’elle protège. Un inventaire fiable recense les serveurs, les postes, les équipements réseau, les logiciels, les comptes à privilèges, les stockages, les applications, les API, les environnements virtualisés et les ressources cloud. Il doit aussi faire apparaître les dépendances techniques : une application critique peut s’appuyer sur un service d’identité, une base de données, un lien WAN ou un fournisseur externe.
Classer les actifs selon leur criticité métier
La priorité diffère entre un poste bureautique, une plateforme e-commerce, un outil de production et un annuaire d’entreprise. Pour chaque actif, évaluez l’impact d’une indisponibilité, d’une corruption ou d’une exfiltration de données. Cette analyse aide à concentrer le budget sur les applications vitales, les données réglementées et les points uniques de défaillance.
Une infrastructure bien documentée facilite aussi les arbitrages entre on-premise, cloud et hybride. Le modèle hybride offre de la souplesse, mais il exige une visibilité homogène sur les accès, les configurations et les flux. Aucun modèle n’est universellement plus sûr. L’entreprise doit définir les responsabilités, la réversibilité et les contrôles adaptés à chaque charge de travail.
2. Fermer les portes d’entrée avec les identités, les configurations et le réseau
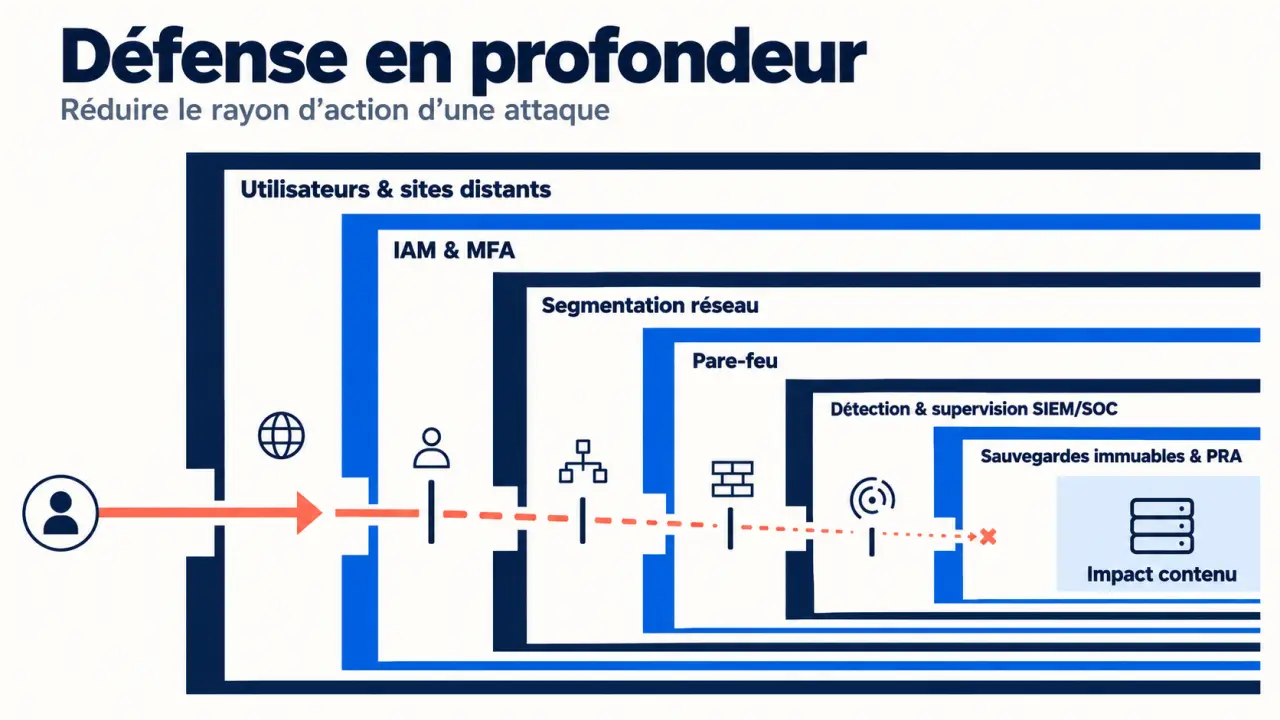
Les attaques commencent souvent par un identifiant compromis, un logiciel non corrigé ou une configuration trop permissive. Une défense en profondeur associe plusieurs contrôles : authentification multifacteur, gestion des identités et des accès (IAM), principe du moindre privilège, mises à jour, chiffrement et segmentation réseau. Aucun dispositif ne suffit seul. Leur combinaison réduit les possibilités d’intrusion et de mouvement latéral.
- Accès : activez le MFA pour les comptes sensibles, les accès distants et les services cloud. Supprimez rapidement les comptes inactifs et révisez régulièrement les droits.
- Configurations : appliquez des standards de durcissement, limitez les services exposés et corrigez les vulnérabilités selon leur criticité.
- Réseau : segmentez les environnements utilisateurs, serveurs, administration et production. Contrôlez les flux entre les différentes zones.
- Données : chiffrez les données au repos et en transit, puis vérifiez qui peut les consulter, les modifier ou les exporter.
La segmentation mérite une attention particulière. Elle limite la circulation d’un incident d’une zone à l’autre. Dans le système d’information, ces barrières réduisent le rayon d’action d’un ransomware et protègent les ressources critiques, même lorsqu’un poste utilisateur est compromis. Le même principe s’applique aux accès distants, aux fournisseurs et aux environnements cloud : chaque connexion doit être limitée au périmètre nécessaire.
3. Détecter vite et préparer une réponse pilotable
La prévention réduit l’exposition, mais elle n’élimine pas tous les incidents. L’entreprise doit centraliser les journaux utiles, surveiller les comportements anormaux et définir les responsabilités lorsqu’une alerte apparaît. Un SIEM consolide les événements de sécurité. Un SOC assure la surveillance, l’analyse et l’escalade selon un niveau de service défini.
Transformer l’alerte en procédure d’intervention
Une alerte exploitable précise le système concerné, le niveau de gravité, le responsable du traitement et les premières actions à mener : isoler un poste, révoquer une session, bloquer un flux, préserver les preuves ou informer la direction. Ces scénarios doivent être testés pour le phishing, la compromission de compte, le malware, le DDoS et l’exfiltration de données.
Après chaque incident, une revue identifie les causes, les lacunes de contrôle et les améliorations à intégrer. Les indicateurs doivent rester compréhensibles : délai de détection, délai de confinement, nombre de comptes à privilèges, taux de correctifs appliqués et réussite des tests de restauration. Les équipes qui souhaitent relier les décisions de sécurité aux enjeux d’exploitation et de gouvernance peuvent voir ces informations pour alimenter leur réflexion.
4. Rendre le PRA et le PCA utilisables après un ransomware
Un plan de continuité d’activité (PCA) organise le maintien des fonctions essentielles. Un plan de reprise d’activité (PRA) organise le retour à la normale après une interruption. Leur efficacité dépend moins du document que de la capacité réelle à restaurer les services dans l’ordre prévu.
| Repère | Question à trancher | Conséquence opérationnelle |
|---|---|---|
| RTO | En combien de temps le service doit-il reprendre ? | Il dimensionne la redondance et les procédures de bascule. |
| RPO | Quelle perte de données est acceptable ? | Il détermine la fréquence des sauvegardes et des réplications. |
Prévoyez des sauvegardes régulières et immuables. Pour les données les plus critiques, isolez-les du réseau principal par un mécanisme air-gapped. Testez la restauration sur des scénarios concrets : annuaire chiffré, serveur applicatif indisponible, données altérées ou site distant isolé. Une sauvegarde non testée ne garantit pas la reprise.
Le test doit aussi vérifier l’ordre de redémarrage des services, les accès des équipes et les décisions à prendre pendant la crise. Une procédure de bascule claire réduit les hésitations lorsque les systèmes habituels ne sont plus disponibles.
5. Gouverner la cybersécurité et choisir le bon accompagnement
La cybersécurité doit être pilotée par la direction, la DSI et le RSSI autour d’une vision commune de la tolérance au risque. Le RGPD, NIS2, DORA, ISO 27001 et HDS ne couvrent pas les mêmes obligations ni les mêmes organisations. Ils convergent toutefois vers des exigences concrètes : maîtrise des accès, traçabilité, gestion des risques, protection des données et préparation aux incidents.
Cette gouvernance doit relier les décisions techniques aux priorités métier. Une application critique, un accès fournisseur ou une sauvegarde stratégique ne se traite pas comme une ressource secondaire. Les responsabilités doivent être documentées entre l’entreprise, les utilisateurs, les fournisseurs cloud et les prestataires de sécurité.
Lors du choix d’un prestataire, vérifiez sa capacité à couvrir votre périmètre réel : audit, architecture, sécurité cloud, supervision, réponse à incident, sauvegarde et exploitation. Demandez aussi des précisions sur la répartition des responsabilités, les modalités d’escalade, les compétences disponibles, la couverture 24/7 si nécessaire et les conditions de réversibilité.
Un partenaire adapté ne remplace pas la gouvernance interne. Il la renforce avec une expertise opérationnelle, des procédures testées et une visibilité continue sur les risques. La bonne approche consiste à combiner priorisation métier, contrôles techniques, supervision et tests réguliers, afin de protéger l’activité sans ajouter une complexité difficile à exploiter.